生成AIを使った問い合わせ対応では、「FAQを登録すれば本当に実用的な回答が返るのか」「言い換えや誤字にも対応できるのか」「FAQにないことを勝手に答えないか」が気になります。
そこで、架空のスマートホームサービス「LumiHome」の日本語FAQを20本作成し、Zendeskの公開Web Widgetから60問を入力して、AIエージェントの回答を検証しました。
結論からいうと、単純なFAQ検索にとどまらず、言い換え、誤字、数値条件、英語での質問にも対応できました。一方で、細かな条件が回答から抜けることや、追質問の文脈をうまく引き継げないケースも確認できました。
この記事は2026年9月時点の検証結果とZendesk公式情報を基にしています。検証には架空の商品・料金・サポート条件を使用しており、実在するサービスの仕様ではありません。AIエージェントの画面や利用できる機能は、契約プラン、アドオン、契約時期などによって異なる場合があります。
検証結果の要点
- 60問の厳格判定はPASS 46問、PARTIAL 10問、FAIL 4問
- 単発のFAQ質問だけでなく、言い換え、誤字、条件判断、英語質問にも対応できた
- FAQにないエラーコードでは、内容を推測せず有人対応へ案内した
- PARTIALでは、期限、場所、通信ポートなどの細かな条件が抜けた
- FAIL 4問はすべて複数ターンの追質問で、単発質問とは分けて検証する必要がある
検証環境
今回使用したのは、検証用に作成したLumiHomeのヘルプセンターです。Zendeskの標準テーマを使い、実在する企業のサポートサイトに近いFAQ構成にしました。
| 項目 | 内容 |
|---|---|
| ナレッジ | 日本語FAQ 20本 |
| 公開面 | Zendeskの公開Web Widget |
| AIエージェント | LumiHome サポートAI |
| テスト質問 | 60問 |
| 主な分野 | アカウント、初期設定、Wi-Fi、エラーコード、料金、支払い、返品、保証 |
質問は単純な一問一答だけにしていません。直接質問15問、言い換え12問、誤字・表記揺れ8問、条件判断8問、範囲外7問、複数ターン6問、英語4問を用意しました。
各質問には、回答へ含めるべき事実をあらかじめ設定しています。たとえば「新しい機器がネットにつながらない。何から確認する?」では、「2.4GHz帯」「Wi-Fiパスワード」「ルーターから3メートル以内」の3点を正解条件にしました。
ZendeskにはAIエージェント用のテスト機能もありますが、今回は利用者が実際に触れる公開Web Widgetで測定しました。管理画面上のテストだけでなく、公開面で表示、送信、参照元まで確認するためです。
判定方法
回答は次の3段階で判定しました。
| 判定 | 基準 |
|---|---|
| PASS | 期待した事実をすべて明示し、誤情報がない |
| PARTIAL | 中心的な回答は正しいが、一部の条件や案内が抜けている |
| FAIL | 誤答、危険な推測、または追質問への有効な回答がない |
ソースが表示されたことや、何らかの返答が届いたことだけではPASSにしていません。回答本文と、事前に設定した正解条件を1問ずつ照合しました。
再テストで揃える条件
自社で同様の評価を行うときは、質問文だけでなく、FAQと設定の版、対応言語、チャネル、追質問の前の会話も記録します。条件を変えた試行は別に扱い、同じ質問の再試行と全体の結果を混ぜないようにします。
回答の中心が正しくても、期限・対象外条件・次の操作が抜ければ、利用者は手続きを進められないことがあります。期待する事実と、案内に必要な条件を分けて評価項目に残しましょう。
人への案内が表示されたことは、担当者への接続や対応完了を測った結果ではありません。相談先・受付時間・時間外の連絡方法を案内できるかと、担当者へ相談内容が届くかは別に点検します。引き継ぎの役割分担は問い合わせ窓口の運用診断でも整理できます。
60問の結果
60問を一括で測定したログを厳格に再判定すると、結果は次のとおりでした。
| 判定 | 件数 | 割合 |
|---|---|---|
| PASS | 46 | 76.7% |
| PARTIAL | 10 | 16.7% |
| FAIL | 4 | 6.7% |
PASSとPARTIALを合わせると56問、全体の93.3%で、正しい方向の回答または安全な制限回答が得られました。ただし、PARTIALには必要条件の欠落があります。そのため、本記事では93.3%を「正答率」とは扱わず、厳格な正答率に相当する数値はPASSの76.7%としています。
FAILの4問は、すべて複数ターンの追質問でした。1回答目には関連情報が含まれていたものの、2回答目に有効な回答が返らないケースです。自動送信そのものに失敗した試行は、この判定から除外しています。
基本的なFAQへの回答結果
直接質問では、料金、対応OS、エラーコードなどをFAQに沿って回答できました。
対応OSについては、iOS 17以降、Android 12以降、タブレットは対象外という複数の条件を一度に提示しています。
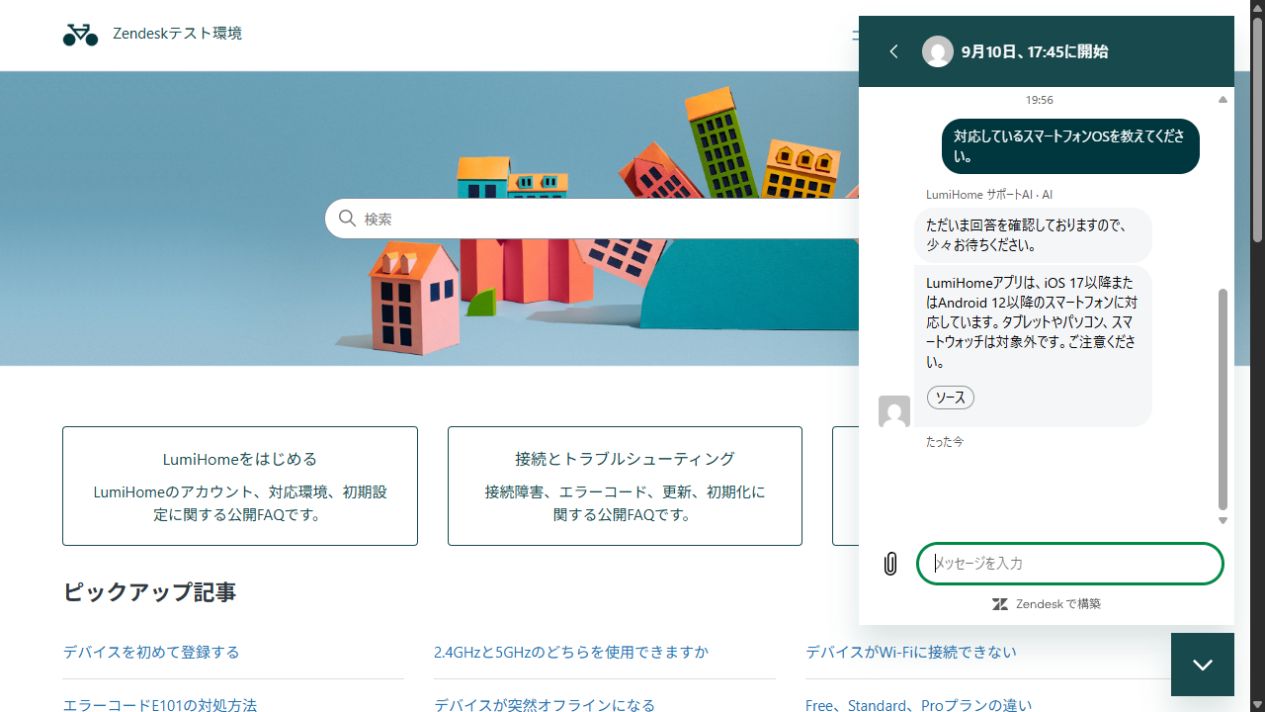
対応OSと対象外端末を、1回の回答で案内した例
「101はどのようなエラーですか?」という、先頭の「E」を省いた質問にも、E101をWi-Fi認証の失敗として認識し、確認手順を案内しました。
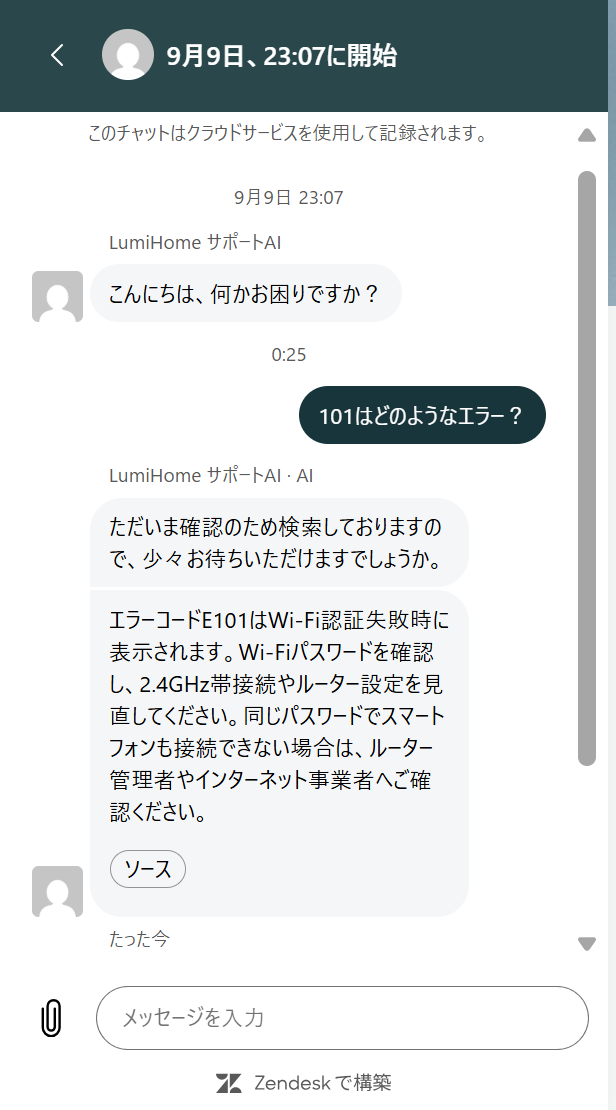
表記が完全一致しなくても、該当するエラーコードの記事を参照した
言い換えや誤字、条件判断にも対応
「WiFiの5gにつなげたい」「E-101 エラーなおしかた」「ファームウエアの手動こうしん」のような表記でも、対応するFAQを見つけて回答しました。
条件判断では、質問に含まれる数値とFAQの条件を比較できています。
たとえば「LumiSensor Aquaを水深50cmで40分使って故障しました。保証対象ですか?」という質問に対して、FAQの「水深1メートル以内、30分以内」という条件を参照し、40分は保証対象外と回答しました。
プラン変更でも、StandardからProへの変更は即時反映と差額の日割り請求、ProからFreeへの変更は次回更新日に反映、といった違いを区別できています。ただし後者では「当月分の返金なし」が抜け、PARTIAL判定になりました。
日本語FAQをもとに英語でも回答できた
英語で行った4問には、すべて英語で回答しました。質問したのは次の内容です。
- E101の原因と対処方法
- Standardプランの月額料金
- 到着10日後の返品
- 対応するiOSとAndroidのバージョン
ここでいう「日本語FAQだけ」は、ナレッジとして登録した記事本文が日本語だけ、という意味です。AIエージェント側では、対応言語として日本語に加えて英語を有効にしています。日本語だけを有効にした設定で同じ結果になる、という意味ではありません。
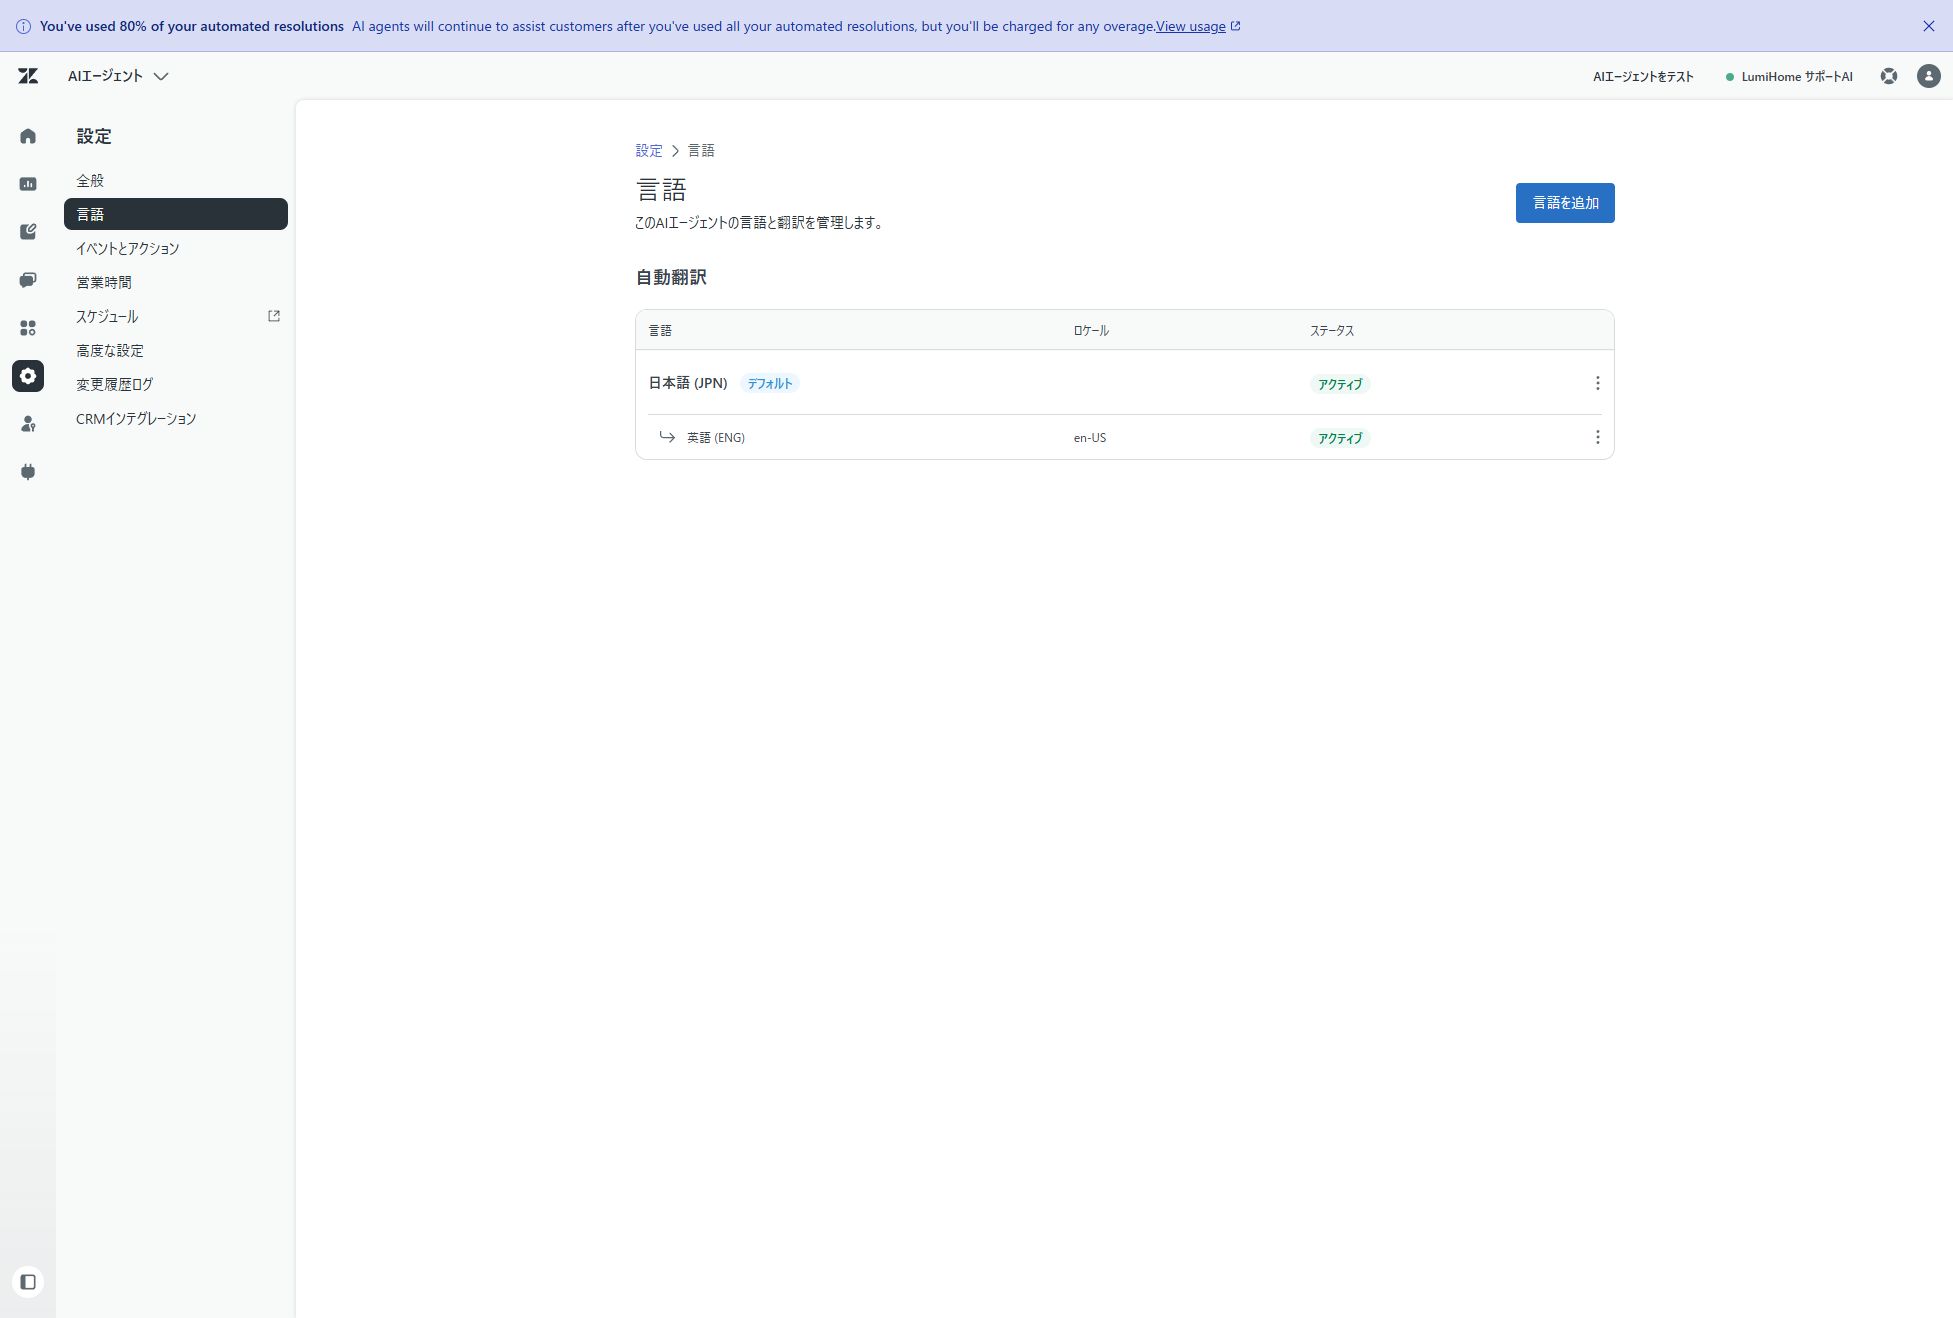
ナレッジ本文は日本語のまま、AIエージェントの対応言語に英語を追加
実際に「How much is the Standard plan per month?」と質問すると、FAQに登録した月額980円を英語で回答しました。
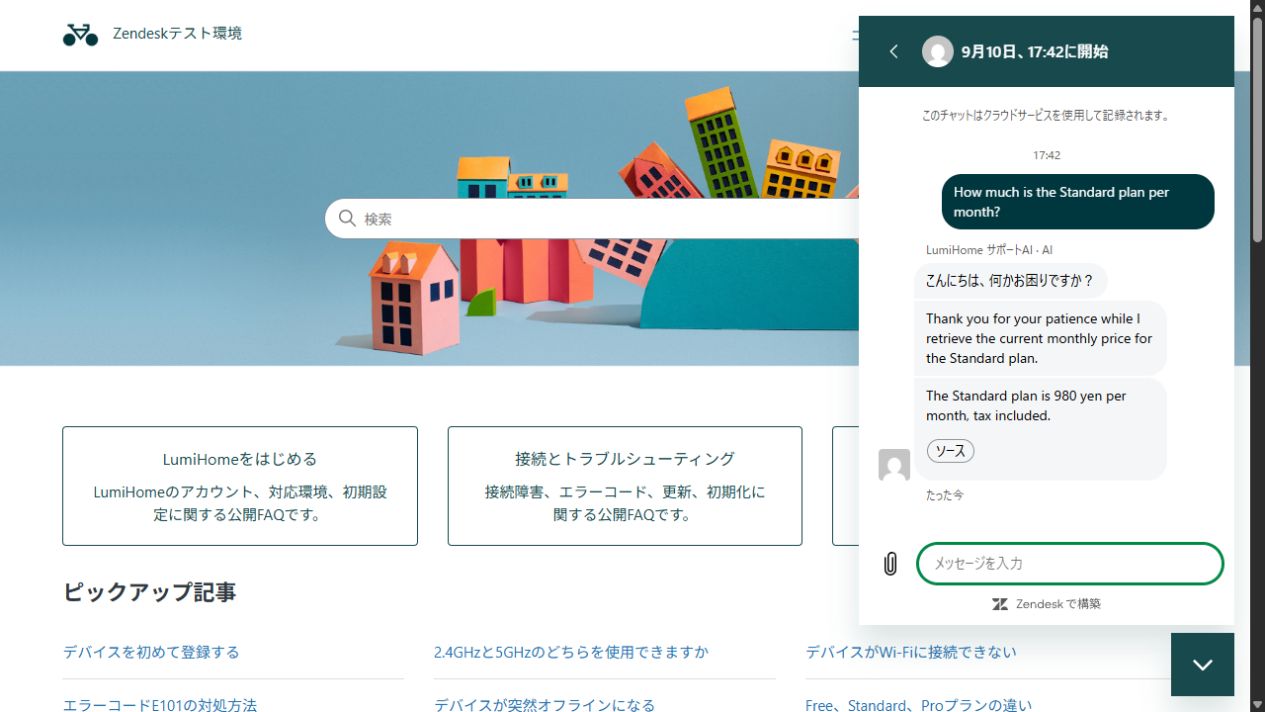
日本語の料金FAQをもとに、英語で回答した例
FAQにない内容は推測しなかった
未掲載のエラーコードE999、海外発送、電話番号、天気、法的責任なども質問しました。
E999については架空の対処方法を作らず、回答できないとして有人対応を案内しました。天気についても、現在は案内できないと伝え、LumiHomeに関する質問へ誘導しています。
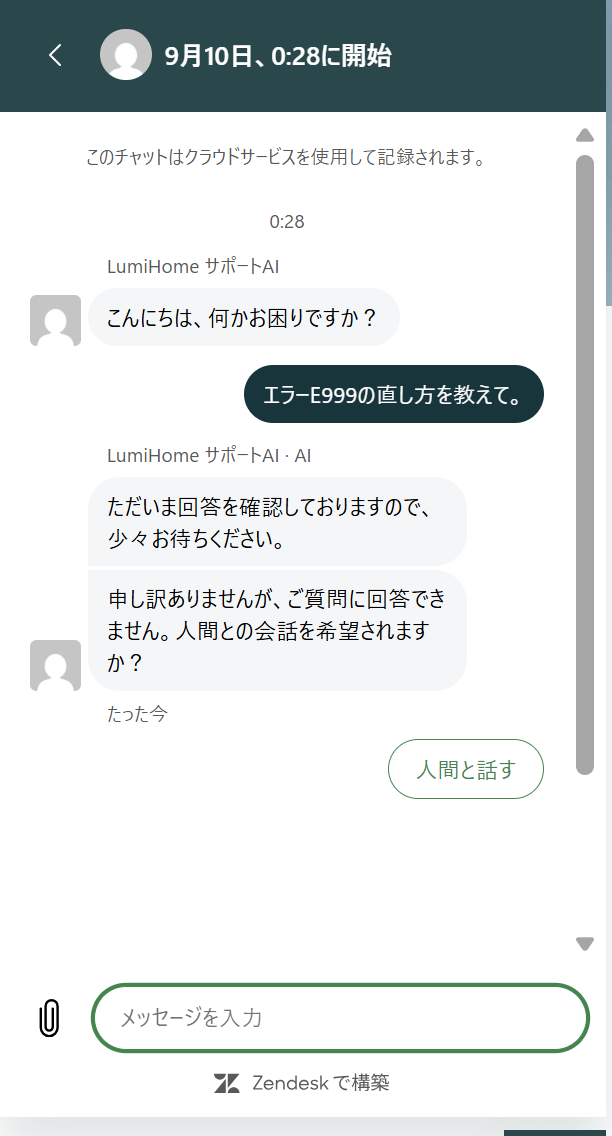
存在しない対処方法を生成せず、人間との会話を案内した例
一方、海外発送や電話番号への回答は「回答できません」という一般的な文面にとどまり、「FAQに情報がない」とまでは説明しなかったため、厳格基準ではPARTIALとしました。
法的責任を判断してほしいという質問でも判断自体は避けましたが、期待していた製品保証の範囲までは案内できませんでした。拒否の安全性と、利用者にとって十分な案内かどうかは、別々に評価する必要があります。
条件の欠落と追質問の課題
今回の検証で特に重要だったのは、完全な誤答よりも見落としやすい「一部条件の欠落」と「会話の文脈切れ」です。
AIエージェントが自然な文章で答えると、一見問題がないように見えます。しかし、返品条件や契約条件が1つ抜けるだけでも、利用者の再問い合わせや手続きのやり直しにつながります。また、1問目に正しく答えていても、続けて入力された短い質問の意味を引き継げなければ、実際のサポート体験は途中で止まってしまいます。
情報の抜け落ちは、利用者が次の行動を誤るかで評価する
PARTIALになった10問は、回答の中心部分は正しいものの、事前に定めた必須条件の一部が抜けた回答です。実務では、抜けた項目の数よりも「その情報がないと利用者が次の行動を誤るか」で重要度を判断する必要があります。
例1:パスワード再設定の有効時間は答えたが、利用回数が抜けた
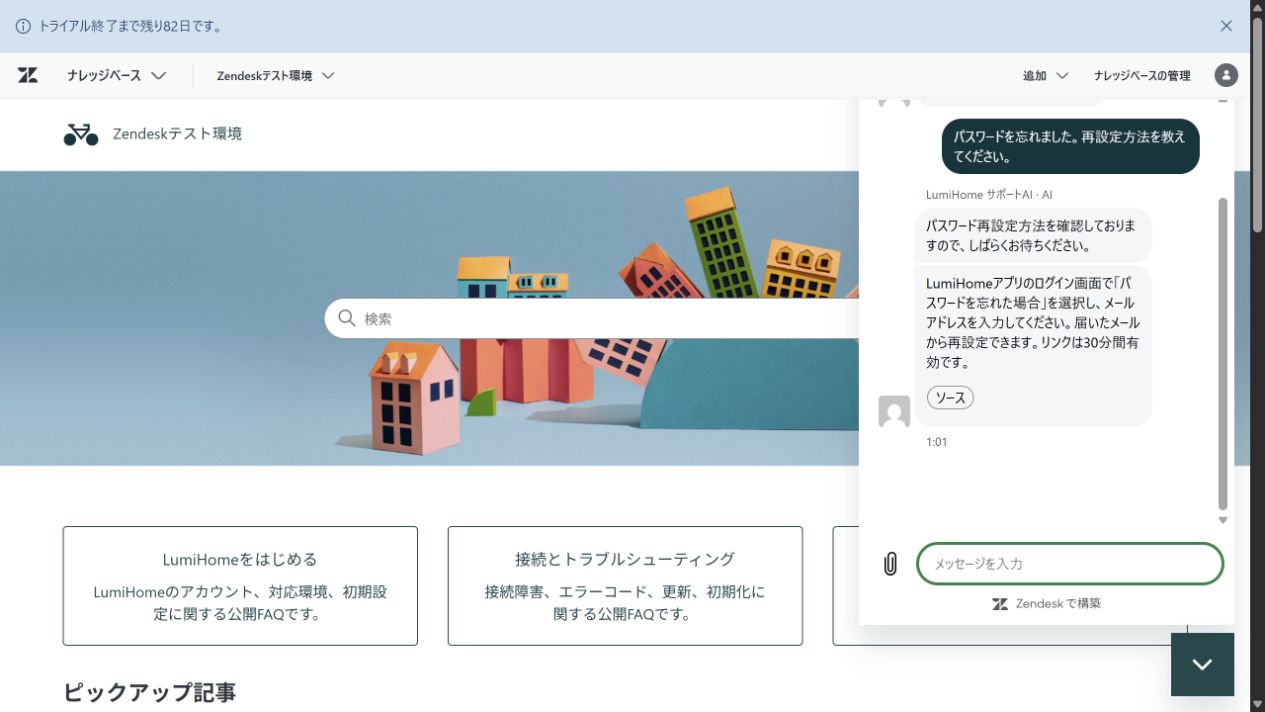
画面右側の公開Web Widgetを拡大表示。再設定方法と30分の有効時間は回答できた
| 確認観点 | 内容 |
|---|---|
| 回答できたこと | ログイン画面から手続きし、メールのリンクを使う。リンクは30分間有効 |
| 抜けたこと | 再設定リンクは1回だけ使用できる |
| 利用者への影響 | 一度開いたリンクを再利用して失敗しても、原因が分からず再問い合わせになる可能性がある |
| FAQの改善案 | 「有効時間30分・使用は1回のみ」を同じ箇条書きにし、使用済みの場合の再送手順も続けて書く |
例2:返品期限は答えたが、返送物の条件が抜けた
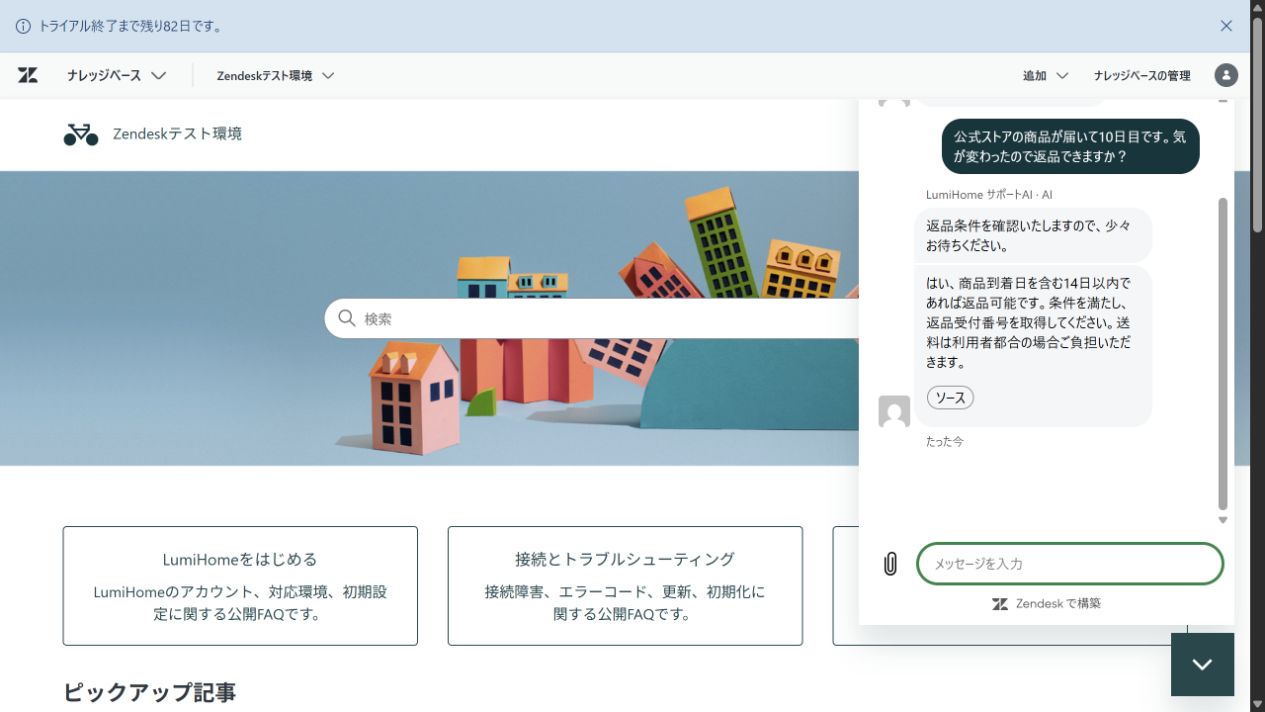
14日以内、返品受付番号、利用者都合の送料負担は回答したが、返送物の条件は含まれなかった
| 確認観点 | 内容 |
|---|---|
| 回答できたこと | 到着日を含む14日以内、返品受付番号の取得、利用者都合の送料負担 |
| 抜けたこと | 製品、付属品、説明書、外箱などをそろえる必要がある |
| 利用者への影響 | 受付後に不足物が判明し、返送のやり直しや返品不可につながる可能性がある |
| FAQの改善案 | 期限・送料とは別に「返送前チェックリスト」を設け、必須の同梱物を列挙する |
ほかにも、本体底面にあるQRコードの場所、登録時にルーターから3メートル以内に置く条件、HTTPS通信で使用するTCP 443、下位プラン変更時に当月分の返金がないことなどが抜けました。
これらをすべて同じ重さで扱うのではなく、契約、料金、保証、セキュリティ、手続きの成否に関わる条件を優先して直すのが現実的です。重要な条件は長い段落の途中へ埋め込まず、「必ず確認すること」として見出しや箇条書きで独立させます。
追質問では、前の話題と追加条件を引き継げるかを見る
実際の利用者は、最初から条件をすべて書くとは限りません。「返品したい」と入力した後で購入場所を伝えたり、「オフラインです」と相談した後で対象が1台だけだと補足したりします。
そのため、AIエージェントの評価では1問目の正しさだけでなく、短い追質問に含まれる「それ」「今日」「1台だけ」といった表現を、直前の話題へ結び付けられるかを見る必要があります。
引き継げた例:購入場所に合わせて返品先を変更
1問目 利用者「製品を返品したい。」
AI「公式ストア購入なら、到着日を含む14日以内に返品を申し込めます」
追質問 利用者「公式ストアではなく家電量販店で買いました。」
AI「公式ストアの返品対象外のため、購入店舗へお問い合わせください」
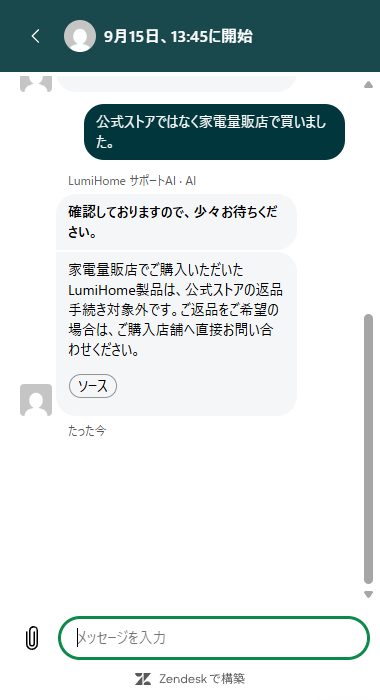
この例では、「返品」という話題を維持したまま、「家電量販店で購入」という追加条件を適用できています。FAQ側で「公式ストア購入」と「他店購入」を明確に分けていたことも、回答しやすさにつながったと考えられます。
引き継げなかった例:「1台だけ」の意味を回答へ反映できない
1問目 利用者「デバイスがオフラインです。」
AI「複数台ならルーター、1台ならデバイス側の問題の可能性があります」
追質問 利用者「オフラインなのは1台だけです。」
AI「どのようなサポートをご希望ですか?」
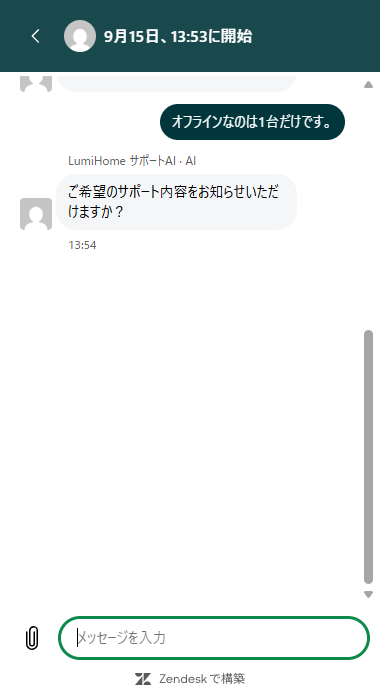
この場合、利用者が求めているのは「1台だけなら何を確認すべきか」という次の手順です。一般的な聞き返しへ戻ると、同じ状況をもう一度説明させることになり、AIエージェントを利用するメリットが薄れます。
対策として、FAQには条件ごとの結論だけでなく、条件が判明した後の次の手順まで書きます。返品、解約、障害切り分けのように会話が続きやすいテーマでは、次の3点をテスト項目にすると実運用に近づきます。
- 1問目の話題を維持できるか
- 追質問で追加された条件を回答へ反映できるか
- 回答できない場合も、何を追加で確認したいのか具体的に聞き返せるか
今回、複数ターンで有効な回答を確認できなかった4ケースを個別に再測定したところ、3ケースでは回答でき、1ケースでは一般的な聞き返しになりました。この補足測定は傾向を見るためのものであり、選択した4件だけの再試行結果を60問全体の正答率には合算していません。
AIエージェント向けFAQを作る7つのポイント
今回の検証から、AIエージェント向けのFAQでは次の点が重要だとわかりました。
- 結論、数値、例外条件を近い位置に書く
- 「上記を確認してください」だけで済ませず、必要な手順を本文へ展開する
- 「1台だけ」「複数台」「公式ストア」「他店」のような分岐条件を明記する
- エラーコード、料金、期間などは表記を統一する
- FAQ外質問の回答不能メッセージと有人移行を確認する
- 対応言語の設定とナレッジの言語を分けて記録する
- 単発質問と追質問を別のテスト項目として測定する
また、テスト時には「質問」「期待する事実」「回答可否」「実際の回答」「判定理由」をセットで記録すると、FAQの不足とAIエージェント側の問題を切り分けやすくなります。Zendeskの会話ログでは、実際のやり取りや使用されたリソースを確認できるため、公開後も同じ観点で改善を続けられます。
まとめ
日本語FAQ20本という小規模な構成でも、Zendesk AIエージェントは直接質問だけでなく、言い換え、誤字、条件判断、英語質問、FAQ外質問に幅広く対応しました。
一方で、FAQにある細かな条件が回答から抜けることや、追質問の文脈を十分に引き継げないケースがあります。「FAQを登録すれば完成」ではなく、正解条件を設定した質問集を用意し、回答ログを見ながらFAQの書き方と会話設計を改善する運用が必要です。
今回の数値は、架空ブランドの20記事、60問、単一のテスト環境で得た結果です。Zendesk AIエージェント全体の一般的な精度を示すものではありません。実際の導入では、自社の問い合わせ履歴や重要な例外条件を使って、同様の評価セットを作ることをおすすめします。
KIRIKOMIでは、Zendeskの初期構築だけでなく、FAQ設計、AIエージェントのテスト設計、会話ログを使った継続改善まで支援しています。詳しくはZendesk導入・運用支援とAIエージェント活用支援をご覧ください。
運用開始後の見直し方は、Zendesk AIエージェント導入後の改善方法|会話ログから回答品質を見直す7つの観点でも解説しています。評価条件の整理から再テストまでの支援は、AIエージェントの回答品質改善をご覧ください。